NVIDIABlackwell Ultra
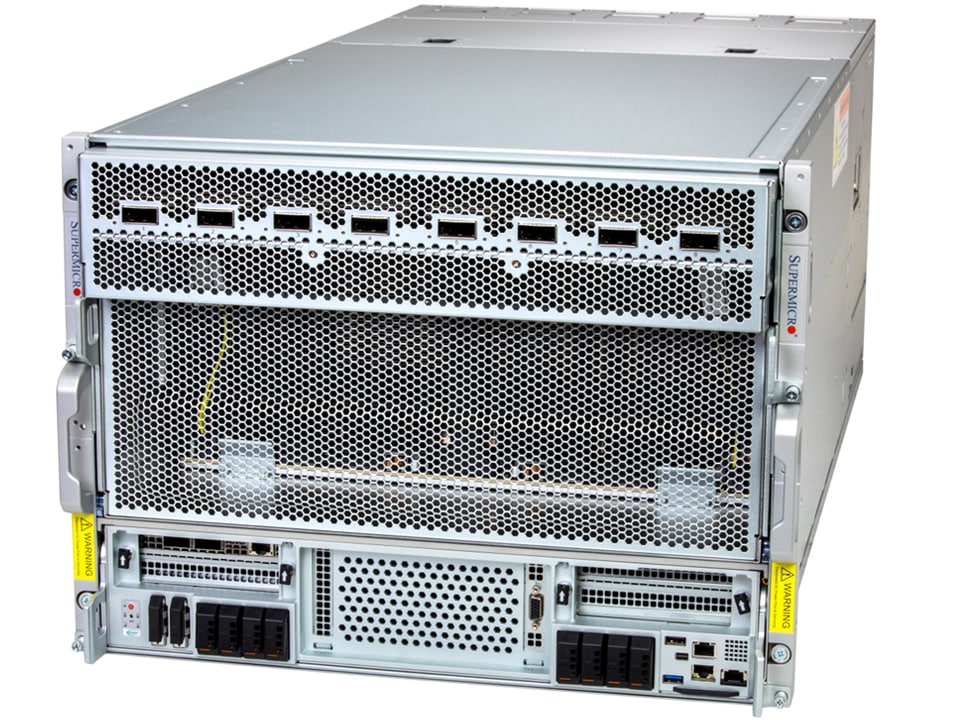
HGX B300 · 8 GPU
Восемь GPU Blackwell Ultra с NVLink 5 Switch. Комплектация и режим охлаждения согласуются с производителем сервера.
- Память ускорителей
- 2 160 GB
- Архитектура и среда
- SXM6 · NVLink 5 SwitchCUDA
от $634 046
 OMNAR
GPU-серверы для бизнеса в Казахстане.
NVIDIA HGX / NVL · AMD Instinct · Huawei Ascend
Покупка, аренда и подготовка к запуску.
Сравните платформы и выберите конфигурацию под вашу задачу.
Восемь GPU Blackwell Ultra с NVLink 5 Switch. Комплектация и режим охлаждения согласуются с производителем сервера.
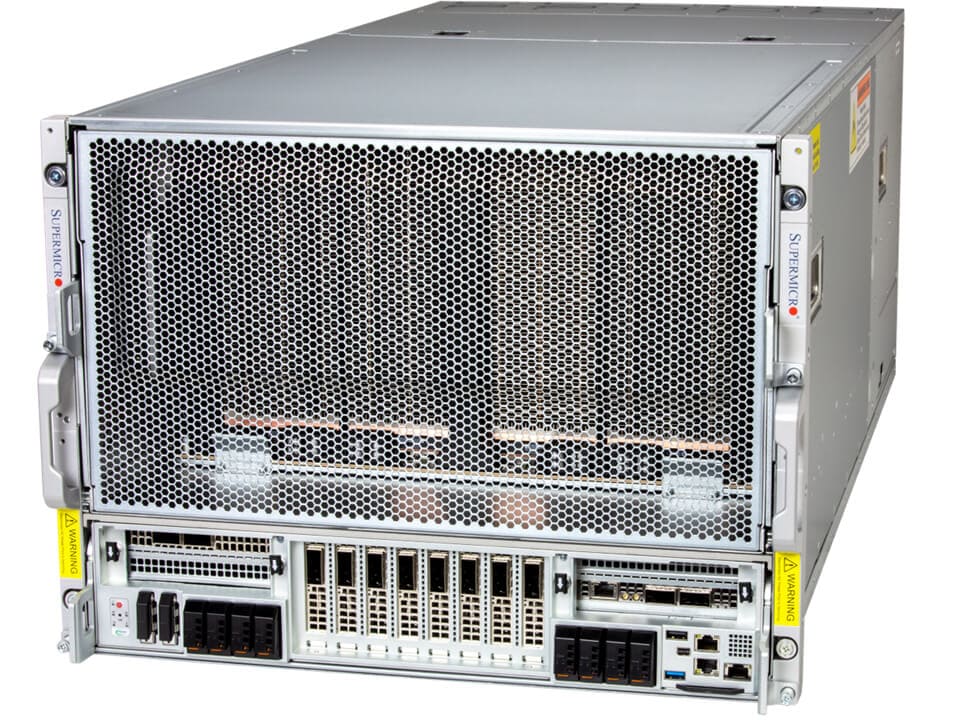
Восемь GPU Blackwell в одном домене NVLink. Сервер и охлаждение подбираются под инфраструктуру.
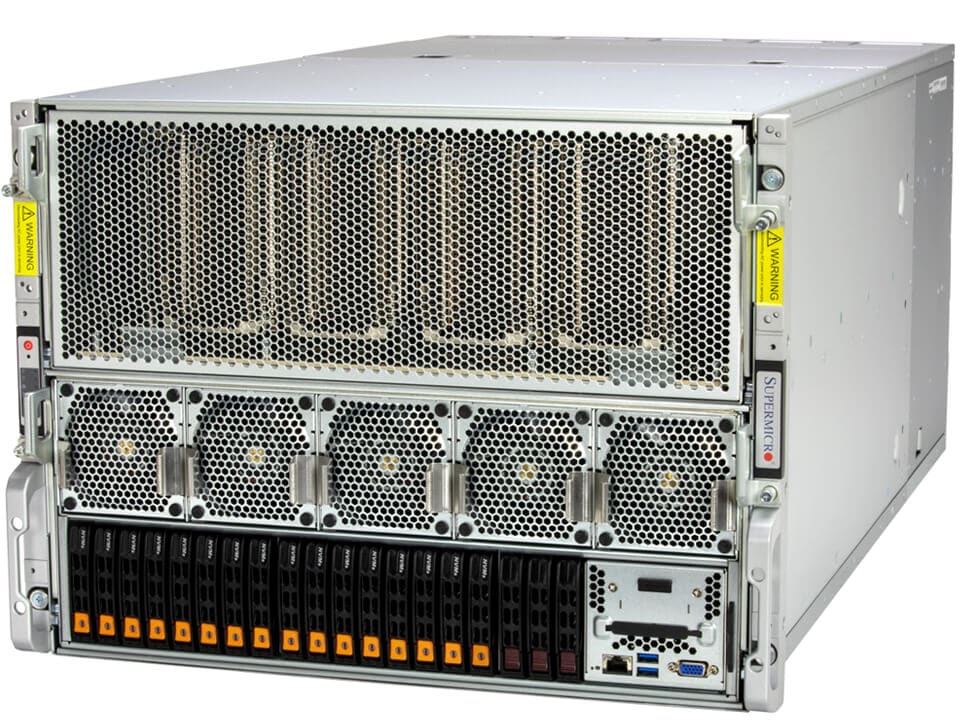
Обучение и инференс на восьми ускорителях с высокоскоростной связью.
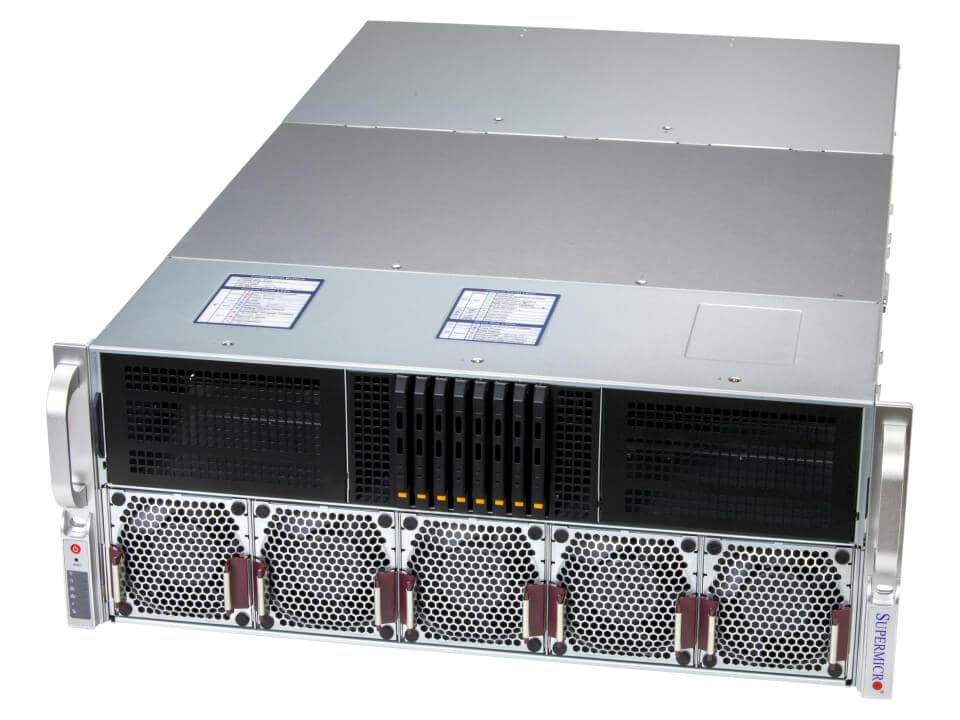
Восемь PCIe GPU: два домена NVLink по четыре GPU. Совместимость сервера и мостов подтверждается в КП.
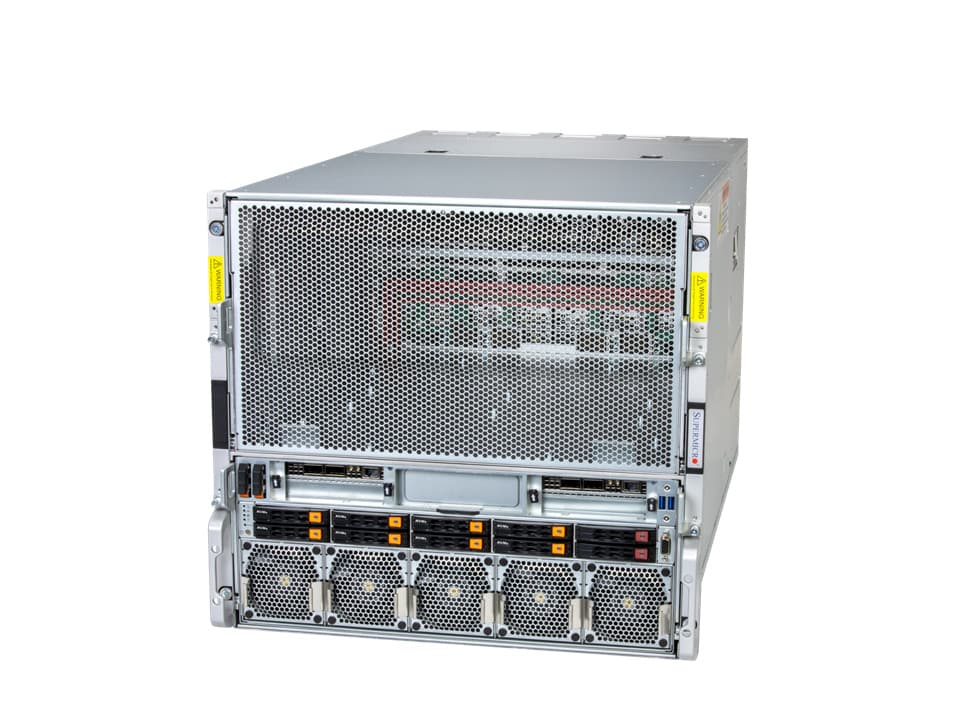
Восемь GPU MI355X. Тип охлаждения, лимиты мощности и требования к площадке зависят от сервера и согласуются в КП.
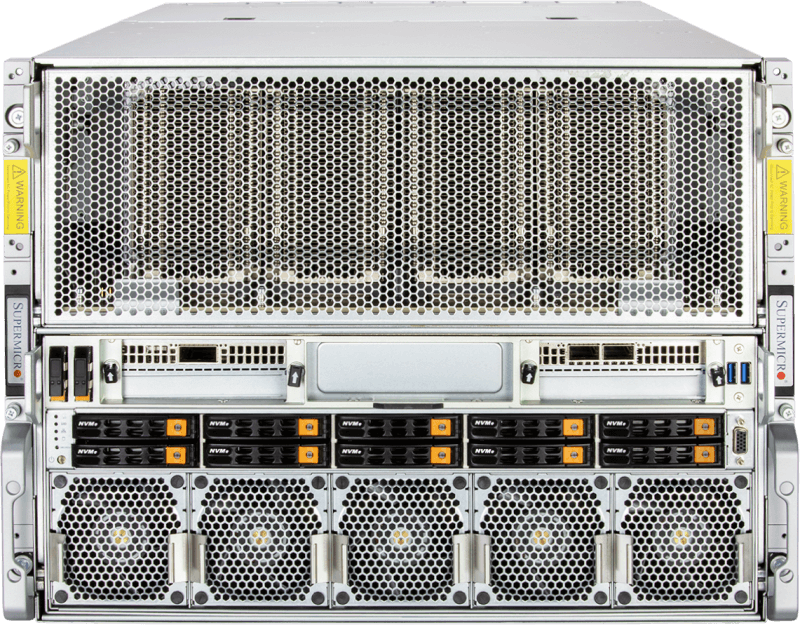
Восемь ускорителей для задач с высокими требованиями к памяти.
На фото — пример готовой системы с этой платформой. Точный корпус, число установленных ускорителей и комплектация фиксируются в КП.
Цены — ориентиры для планирования бюджета, не оферта и не подтверждение наличия. НДС, точная комплектация, доставка, гарантия и срок фиксируются в коммерческом предложении. Память ускорителей указана суммарно; её использование зависит от программного обеспечения и топологии связи.
Выберите модель. Сравните память и стоимость.
| Платформа | Память | Результат расчёта | Обсудить конфигурацию |
|---|---|---|---|
| H200 NVL · 8 GPUNVIDIA · CUDAот $469 168 | 1 128 GB | По памяти подходитостаётся 244,4 GB | |
| HGX H200 · 8 GPUNVIDIA · CUDAот $404 504 | 1 128 GB | По памяти подходитостаётся 244,4 GB | |
| HGX B200 · 8 GPUNVIDIA · CUDAот $480 285 | 1 440 GB | По памяти подходитостаётся 556,4 GB | |
| Instinct MI300X · 8 GPUAMD · ROCmот $356 168 | 1 536 GB | По памяти подходитостаётся 652,4 GB | |
| Instinct MI325X · 8 GPUAMD · ROCmПо запросу | 2 048 GB | По памяти подходитостаётся 1 164,4 GB | |
| HGX B300 · 8 GPUNVIDIA · CUDAот $634 046 | 2 160 GB | По памяти подходитостаётся 1 276,4 GB |
Номинальная память — оценка ёмкости. Сборка, ПО, топология и доступность проверяются отдельно.
Проверка источников:753 млрд — параметров в чекпойнте. 39 млрд — активны на токен.
Опубликованный чекпойнт: FP8 / BF16 / F32. Объём весов из опубликованного чекпойнта или официального руководства. Это размер сохранённых весов, не замер GPU-памяти: преобразование при запуске может увеличить объём. Резерв добавлен отдельно.
Формат весов: Начинайте с опубликованного чекпойнта. Дополнительное квантование может влиять на качество; перевод уже квантованных весов в BF16 не восстанавливает потерянную точность.
Рабочий резерв: Память сверх весов для KV-кэша, активаций, рабочих буферов и запаса на всю выбранную конфигурацию, а не на одну GPU. Задавайте по длине контекста и числу одновременных запросов, затем проверяйте пиковый расход. Быстрые значения — примеры, а не универсальные рекомендации.
Карточка модели ↗Объём опубликованных весов ↗Опубликованное руководство запуска ↗Это предел, указанный в конфигурации модели, а не контекст, проверенный на выбранном оборудовании.
DSA использует kv_lora_rank=512 и индексаторы full/shared. Для кэша нужен расчёт с учётом этой архитектуры.
Config модели ↗Config контекста проверен: .
Нужна проверка среды исполнения. Опубликованное руководство запуска: HGX H200 · 8 GPU, Instinct MI355X · 8 GPU, Instinct MI325X · 8 GPU, Instinct MI300X · 8 GPU.
Веса = все параметры × байт на параметр: BF16 — 2, FP8 — 1, INT4 — 0,5. Единицы — десятичные GB. Для MoE учитываются все эксперты, а не только активные параметры. Это нижняя оценка: масштабы квантования, слои без квантования и метаданные отдельно не рассчитаны; они должны помещаться в резерв.
Зелёный статус — оценка вместимости, а не проверенный запуск. Память распределена между GPU. Нужно проверить тензорный и экспертный параллелизм, межсоединения, ядра и поддержку фреймворка. Длинный контекст и параллельные пользователи могут потребовать гораздо больший резерв. Для дообучения и обучения нужен отдельный расчёт.
KV-кэш зависит от длины контекста, одновременных запросов, точности кэша и архитектуры внимания модели. Скользящее окно, линейное внимание и сжатый кэш требуют отдельной оценки; пиковый расход проверяется в выбранной среде исполнения. Поле меняет оценку вместимости, а не настройки сервера.
Hugging Face: Стратегии KV-кэша ↗vLLM: Распределение гибридного кэша ↗BF16 / FP8 / INT4 — сценарии объёма. Названия форматов не подтверждают нативную поддержку на GPU и одинаковое качество модели.
Для NVL отдельно проверяются топология и распределение модели: PCIe-сервер с 8 GPU не эквивалентен фабрике HGX/NVSwitch. Перед запуском нужно проверить конкретный чекпойнт и ядра в ROCm.
Huawei Ascend использует CANN. Результат по памяти не подтверждает запуск выбранного чекпойнта, операторов или точности на этих платформах. Нужны порт модели и проверка среды исполнения.
По спецификации NVIDIA в расчёте используется 270 GB на GPU для HGX B300 и 279 GB на GPU для GB300. Значение 288 GB не используется. Оперативная память CPU не прибавляется к GPU-памяти. NVIDIA Blackwell Ultra (PDF) ↗
Открытые веса не означают отсутствие ограничений. Проверьте лицензию каждой модели и руководство по запуску.
Обсудим выделенную конфигурацию под вашу нагрузку. Срок аренды, размещение, доступ и условия поддержки согласуем до запуска.
Рассчитать аренду↗От первой спецификации до передачи оборудования. Работаем с компаниями в Казахстане и подбираем инфраструктуру под конкретную нагрузку.
Модель, точность, объём памяти, число пользователей и целевая производительность.
NVIDIA, AMD или Huawei. Сравниваем память, связи между ускорителями, программную совместимость и стоимость владения.
Спецификация, проверка оборудования, договор, оплата по счёту и условия гарантии.
OMNAR — казахстанский поставщик GPU-серверов. Подбираем оборудование для компаний в Казахстане, готовим предложения на покупку и выделенную аренду.
Казахстанское юридическое лицо, расчёт предложения в тенге и оплата по счёту.
Оборудование, доставка, налоги и дополнительные услуги раскрываются в коммерческом предложении.
Сервер на вашей площадке или выделенная аренда с согласованным размещением и доступом.
Три отправные точки для разговора об инфраструктуре.
Зафиксируйте модель, контекст, число пользователей и допустимое время ответа.
Что подготовитьОпишите данные, методы дообучения и длительность запусков. Сравните покупку с арендой на одном сценарии.
Что подготовитьПроверьте площадку, питание, охлаждение и сеть до согласования серверов или целой стойки.
Что подготовитьПодробности собраны в отдельных руководствах — от первой оценки памяти до приёмки сервера.
Какие сведения о задаче, нагрузке и эксплуатации нужны, чтобы сравнить предложения и проверить результат перед заказом.
Читать руководство: Как подготовить ТЗ на GPU-серверКак разделить веса, KV-кэш и рабочий резерв, учесть MoE и проверить оценку на реальной нагрузке.
Читать руководство: Сколько GPU-памяти нужно языковой моделиКак сравнить два варианта на одной задаче: загрузка, срок использования, контроль и полная стоимость.
Читать руководство: Купить или арендовать GPU-серверОт стойки и питания до доступа, версий ПО и приёмки: что согласовать до доставки оборудования.
Читать руководство: Как подготовить площадку к GPU-серверуРасскажите о модели и планируемой нагрузке. Отправьте запрос на сервер или аренду — с важными деталями для подготовки предложения.
Начните с вашей модели и программного стека: CUDA для NVIDIA, ROCm для AMD и CANN для Huawei. Затем проверьте формат весов, распределение памяти и производительность на реальной нагрузке. Одинаковый объём памяти не делает платформы взаимозаменяемыми.
Цена зависит от комплектации и условий поставки. Запросите коммерческое предложение с итоговой стоимостью в тенге, указанием НДС, сроком поставки и гарантией. Наличие подтверждается в КП.
HGX H200 использует платформу SXM с NVSwitch. PCIe-сборка на H200 NVL требует проверки совместимости и может состоять из двух групп по четыре GPU. Это не эквивалент единой восьмичиповой фабрики HGX.
Уточняются конфигурация, срок, дата-центр, подключение, режим доступа и поддержка. Доступность мощностей и дата начала подтверждаются индивидуально; мгновенный запуск не обещается.